Mục tiêu: Cho máy tính dữ liệu số giờ học → điểm thi, sau đó yêu cầu máy dự đoán điểm của một học sinh mới.
1. Bài toán
Chúng ta có Dataset:
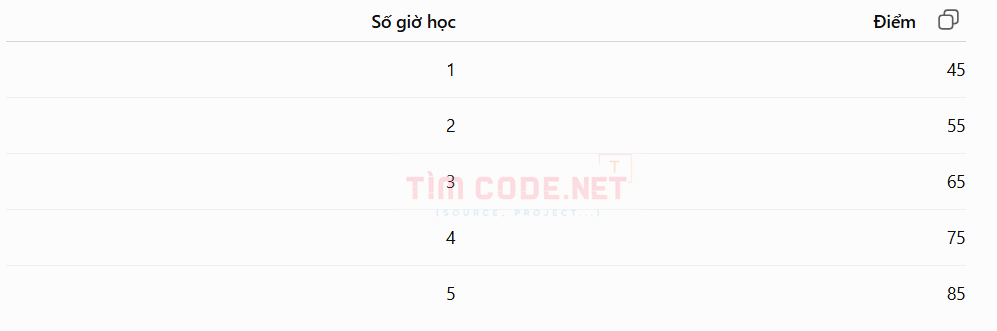
Chúng ta muốn AI học được quy luật: Số giờ học tăng -> Điểm thường tăng
Sau đó hỏi: Nếu học 6 giờ, dự đoán điểm khoảng bao nhiêu?
2. Xác định Feature và Label
Feature: Số giờ học
Label: Điểm
Trong Python, chúng ta biểu diễn:
X = [1, 2, 3, 4, 5]
y = [45, 55, 65, 75, 85]
Ở đây:
X→ Featurey→ Label
Bạn sẽ gặp cách đặt tên này rất thường xuyên trong Machine Learning.
3. Cài thư viện Machine Learning
Chúng ta sẽ sử dụng scikit-learn.
Nếu máy bạn đã cài Python, mở Terminal/CMD:
pip install scikit-learnSau đó kiểm tra:
python --versionVí dụ:
Python 3.13.x4. Model đầu tiên
Chúng ta sử dụng một thuật toán rất cơ bản:
Linear Regression – Hồi quy tuyến tính
Ý tưởng đơn giản:
X → Model → yModel cố gắng tìm một đường phù hợp với dữ liệu.
Với dữ liệu của chúng ta:
1 giờ → 45
2 giờ → 55
3 giờ → 65
4 giờ → 75
5 giờ → 85
Có thể hình dung:
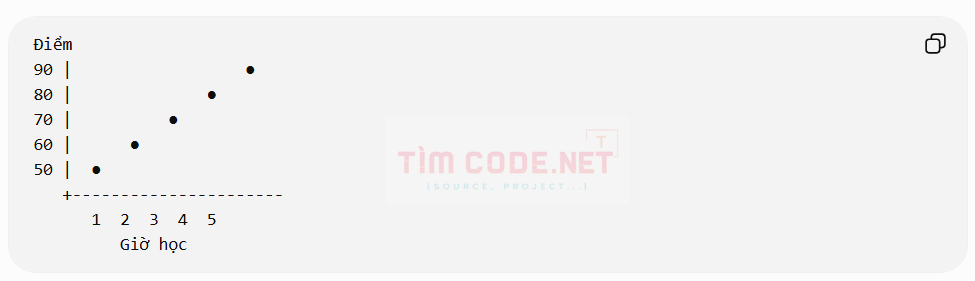
Model sẽ tìm ra mối quan hệ gần giống:
Điểm ≈ 10 × Số giờ + 355. Code Machine Learning đầu tiên
from sklearn.linear_model import LinearRegression

# 1. Feature
X = [[1], [2], [3], [4], [5]]

# 2. Label
y = [45, 55, 65, 75, 85]

# 3. Tạo model
model = LinearRegression()

# 4. Training
model.fit(X, y)

# 5. Dự đoán học 6 giờ
prediction = model.predict([[6]])

print("Dự đoán:", prediction[0])
Kết quả sẽ xấp xỉ:
Dự đoán: 95.0Đây chính là Machine Learning.
Bạn vừa:
Bạn vừa:
Dataset
  ↓
Feature + Label
   ↓
Model
   ↓
Training
   ↓
Prediction
6. Giải thích từng dòng
Dòng 1
from sklearn.linear_model import LinearRegressionChúng ta lấy thuật toán Linear Regression từ Scikit-learn.
Dòng 2
X = [[1], [2], [3], [4], [5]]Đây là Feature.
Tại sao lại viết:
[[1], [2], [3]]mà không viết:
[1, 2, 3]?
Vì Scikit-learn thường mong đợi dữ liệu Feature có dạng:
[sample, feature]Ví dụ:
[[1],[2],[3],[4],[5]]Có 5 mẫu, mỗi mẫu có 1 feature.
Dòng 3
y = [45, 55, 65, 75, 85]Đây là Label.
Có 5 Feature thì có 5 Label tương ứng:
X     y
1  → 45
2  → 55
3  → 65
4  → 75
5  → 85
7. Tạo Model
model = LinearRegression()Ở đây chúng ta tạo một Machine Learning Model.
Nhưng lúc này model chưa học gì cả.
Giống như một học sinh mới bắt đầu học.
8. Training
model.fit(X, y)Đây là dòng quan trọng nhất.
.fit() nghĩa là:
Cho model học từ dữ liệu.
Model nhận:
X = Số giờ họcy = Điểm
và tìm ra mối quan hệ giữa chúng.
9. Prediction
Sau khi học xong:
prediction = model.predict([[6]])Chúng ta đưa vào:
6 giờModel trả về:
≈ 95 điểmĐây gọi là:
Prediction – dự đoán.
10. Model thực sự học được gì?
Đây là phần rất thú vị.
Linear Regression cố gắng tìm công thức:
y = ax + bTrong đó:
x= số giờ họcy= điểma= hệ sốb= điểm bắt đầu
Bạn có thể xem model học được:
print("Hệ số:", model.coef_)print("Intercept:", model.intercept_)
Kết quả gần như:
Hệ số: [10.]Intercept: 35.0
Tức là model học được:
Điểm = 10 × Số giờ học + 35Kiểm tra:
1 giờ → 10 × 1 + 35 = 45
2 giờ → 10 × 2 + 35 = 55
3 giờ → 10 × 3 + 35 = 65
Và:
6 giờ → 10 × 6 + 35 = 9511. Nhưng đây có thật sự là AI không?
Có, đây là một ví dụ rất đơn giản của Machine Learning, và Machine Learning là một nhánh của AI.
Tuy nhiên, đừng nhầm:
Machine Learning không nhất thiết phải là những hệ thống cực kỳ phức tạp như ChatGPT.
Nó có thể bắt đầu từ một bài toán rất đơn giản:
1 → 45
2 → 55
3 → 65
4 → 75
5 → 85
rồi dần dần trở nên phức tạp hơn.
12. Từ ví dụ nhỏ đến AI thực tế
Ví dụ hôm nay:
1 Feature
    ↓
Linear Regression
    ↓
1 Prediction
Sau này có thể là:
100 Features
      ↓
Machine Learning
      ↓
Dự đoán doanh số
Hoặc:
Hàng triệu dữ liệu
     ↓
Deep Learning
      ↓
Nhận diện hình ảnh
Hoặc:
Hàng tỷ token
     ↓
Transformer
     ↓
Large Language Model
     ↓
ChatGPT
Bạn đang đi từ viên gạch đầu tiên.
🧠 Kiến thức cần nhớ sau Bài 4
Bạn cần thuộc 5 dòng này:
X = Feature
y = Label
model.fit(X, y)
        ↓
     Training
model.predict(...)
        ↓
    Prediction
Và quy trình:
Dataset
  ↓
Feature + Label
   ↓
Training
   ↓
Model
   ↓
Prediction
🎯 Bài tập Bài 4
Không cần dùng dữ liệu điểm thi nữa. Hãy thử tự xây một model dự đoán:
Số giờ học → điểm thi
Nhưng lần này Dataset là:
Giờ học: 1, 2, 3, 4, 5, 6Điểm: 40, 50, 60, 70, 80, 90
Hãy sửa code để model dự đoán:
Học 8 giờ thì được bao nhiêu điểm?
Gợi ý
Bạn chỉ cần thay:
X = ...
y = ...
và:
model.predict([[8]])Đừng lo nếu chưa tự viết được. Mục tiêu của Bài 4 là bạn bắt đầu hiểu rằng Machine Learning thực chất là:
Đưa dữ liệu vào → cho Model học → đưa dữ liệu mới vào → Model dự đoán.