Chúng ta có sơ đồ sau:
Dữ liệu
   ↓
Model
   ↓
Training
   ↓
Prediction
Nhưng có một vấn đề:
Làm sao biết Model thực sự học tốt, chứ không chỉ nhớ dữ liệu đã được đưa cho nó?
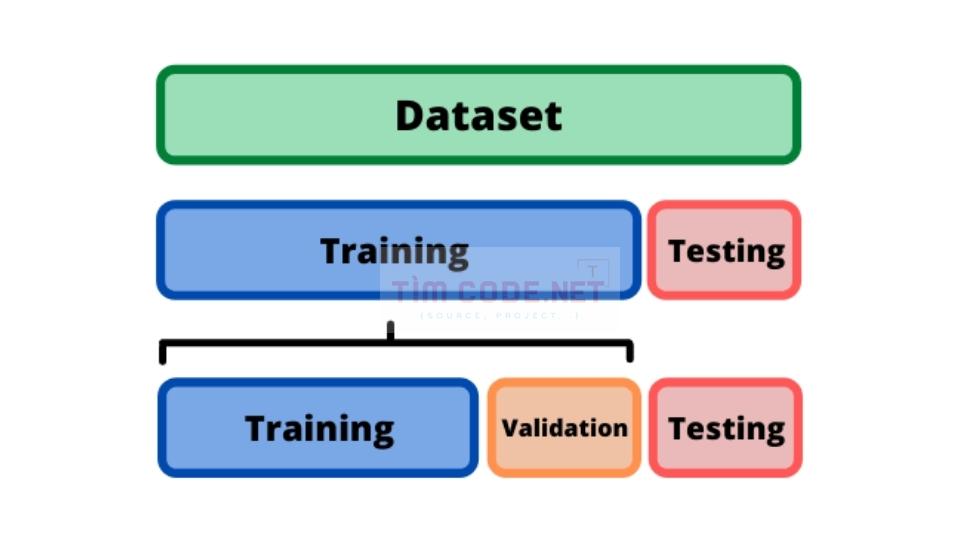
Đó là lý do chúng ta cần Training Set và Test Set.
1. Training Set là gì?
Training Set là phần dữ liệu dùng để cho Model học.
Ví dụ có 1000 mẫu dữ liệu:
1000 mẫu
   ↓
Training Set
   ↓
800 mẫu
   ↓
Model học
Model được phép nhìn thấy 800 mẫu này trong quá trình training.
Ví dụ:
Giờ học: 1 2 3 ......800...
Điểm: 45 55 65 ... ....
Model sử dụng chúng để tìm ra quy luật.
2. Test Set là gì?
Test Set là phần dữ liệu không dùng để training.
Ví dụ:
1000 mẫu dữ liệu
│
├── 800 → Training Set
│
└── 200 → Test Set
Sau khi Model học xong, chúng ta đưa 200 mẫu chưa từng được học cho Model.
Mục đích:
Kiểm tra xem Model có khả năng dự đoán dữ liệu mới hay không.
3. Ví dụ cực kỳ dễ hiểu
Hãy tưởng tượng bạn học toán.
Thầy giáo cho bạn:
📚 Bài tập luyện
1 + 1 = ?
2 + 2 = ?
3 + 3 = ?
...
Bạn làm những bài này nhiều lần.
Đây giống:
Training Set
Sau đó thầy cho một bài kiểm tra:
17 + 25 = ?Bạn chưa từng thấy câu này.
Đây giống:
Test Set
Nếu bạn làm đúng:
Có khả năng bạn đã hiểu cách giải.
Nếu chỉ nhớ đáp án của những bài cũ:
Bài mới có thể làm sai.
Machine Learning cũng tương tự.
4. Tại sao không dùng toàn bộ dữ liệu để Training?
Giả sử chúng ta có:
1000 dữ liệuNếu cho cả 1000 dữ liệu vào training:
1000
 ↓
Model
Sau đó kiểm tra Model bằng chính 1000 dữ liệu đó:
1000 dữ liệu
 ↓
Model
 ↓
99% chính xác
Có vẻ rất tốt! 😄
Nhưng thực tế...
Chưa chắc Model tốt.
Vì Model đã được nhìn thấy toàn bộ dữ liệu.
Giống như:
Bạn được cho đề thi và đáp án trước, sau đó thi lại đúng đề đó.
Điểm 100% không chứng minh bạn hiểu bài.
5. Chia dữ liệu
Cách phổ biến cho người mới học:
                 DATASET
                    │
             ┌──────┴──────┐
             ↓             ↓
        Training Set    Test Set
           80%             20%
             │               │
             ↓               │
          Training            │
             │               │
             ↓               │
           MODEL              │
             │               │
             └───────┬───────┘
                     ↓
                 Testing
                     ↓
               Đánh giá Model
Ví dụ:
1000 mẫu
│
├── 800 mẫu → Training
│
└── 200 mẫu → Testing
Tỷ lệ 80/20 là một ví dụ phổ biến, nhưng không phải lúc nào cũng phải đúng 80/20.
6. Ví dụ với bài toán của chúng ta
Giả sử Dataset:
Giờ học -> Điểm
1 -> 45
2 -> 55
3 -> 65
4-> 75
5 -> 85
6 -> 95
7 -> 100
8-> 100
Chúng ta có thể chia:
Training
1 → 45
2 → 55
3 → 65
4 → 75
5 → 85
6 → 95
Test
7 → 100
8 → 100
Model học dữ liệu Training.
Sau đó chúng ta kiểm tra bằng Test:
7 giờ → Model dự đoán ?
8 giờ → Model dự đoán ?
7. Làm bằng Python
Scikit-learn có sẵn công cụ:
train_test_splitVí dụ:
from sklearn.model_selection import train_test_split

X = [[1], [2], [3], [4], [5], [6], [7], [8]]

y = [45, 55, 65, 75, 85, 95, 100, 100]

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
Sau khi chạy:
X_train → dữ liệu training
y_train → đáp án training

X_test  → dữ liệu test
y_test  → đáp án test
8. Training Model
from sklearn.linear_model import LinearRegression

model = LinearRegression()

model.fit(X_train, y_train)
Dòng:
model.fit(X_train, y_train)nghĩa là:
Cho Model học Training Set.
9. Kiểm tra Model
Sau khi học:
predictions = model.predict(X_test)Ví dụ:
X_test

[7]
[8]
Model có thể dự đoán:
[105]
[115]
Trong khi đáp án thật:
[100]
[100]
Model chưa tốt lắm.
10. Accuracy là gì?
Với một số bài toán Classification, chúng ta thường quan tâm đến:
Accuracy – độ chính xác
Ví dụ Model phân loại 100 hình ảnh:
Đúng: 90
Sai: 10
Accuracy:
90 / 100 = 90%Nhưng không phải mọi bài toán đều dùng Accuracy.
Ví dụ bài toán dự đoán giá:
Giá thật:      10 triệu
Model đoán:    10.5 triệu
Đây là bài toán Regression, nên thường dùng các chỉ số sai số như MAE, MSE, RMSE, R².
Chúng ta sẽ học từng cái sau.
11. Một khái niệm cực kỳ quan trọng: Overfitting
Đây là một trong những vấn đề quan trọng nhất của Machine Learning.
Giả sử Model học quá kỹ Training Set.
Training: ⭐⭐⭐⭐⭐
Test:     ⭐⭐
Model rất giỏi với dữ liệu đã học.
Nhưng khi gặp dữ liệu mới thì dự đoán kém.
Đó gọi là:
Overfitting – quá khớp dữ liệu.
12. Ví dụ đời thường
Bạn học:
1 × 1 = 1
1 × 2 = 2
1 × 3 = 3
...
Nếu bạn hiểu phép nhân, khi gặp:
7 × 8 = ?bạn giải được.
Nhưng nếu bạn chỉ:
Nhớ từng câu hỏi và đáp án.
Khi đề thay đổi:
8 × 7 = ?có thể bạn gặp khó khăn.
Machine Learning cũng muốn tránh tình trạng:
"Nhớ dữ liệu" thay vì "học quy luật".
13. Underfitting là gì?
Ngược lại với Overfitting là Underfitting.
Model quá đơn giản hoặc chưa học đủ:
Training: ⭐⭐
Test:     ⭐⭐
Nó làm không tốt ngay cả trên dữ liệu training.
Có thể hình dung:
Underfitting
↓
Model học chưa đủ

Good fit
↓
Model học được quy luật

Overfitting
↓
Model học quá sát dữ liệu
Mục tiêu của chúng ta:
Học được quy luật tổng quát.
🧠 14. Ba khái niệm cần nhớ
Training Set
     ↓
Dùng để Model học

Test Set
     ↓
Dùng để kiểm tra Model

Overfitting
     ↓
Model nhớ quá sát Training Set
15. Quy trình Machine Learning đầy đủ hơn
Đến đây chúng ta có thể mở rộng sơ đồ:
                 DATASET
                    │
                    ↓
             Chia dữ liệu
              ┌─────┴─────┐
              ↓           ↓
          TRAINING       TEST
              │           │
              ↓           │
            MODEL          │
              │           │
              └─────┬─────┘
                    ↓
                 DỰ ĐOÁN
                    ↓
              ĐÁNH GIÁ MODEL
                    ↓
          Model tốt hay chưa?
Đây là quy trình nền tảng mà bạn sẽ gặp liên tục khi học Machine Learning.
🎯 Bài tập Bài 5
Giả sử bạn có 10.000 dữ liệu bán hàng.
Bạn muốn xây AI dự đoán số lượng sản phẩm bán ra ngày hôm sau.
Hãy trả lời 4 câu:
1. Nếu chia dữ liệu 80/20 thì có bao nhiêu mẫu Training và bao nhiêu mẫu Test?
2. Training Set dùng để làm gì?
3. Test Set dùng để làm gì?
4. Nếu Model đạt 99% trên Training Set nhưng chỉ 65% trên Test Set, bạn nghi ngờ vấn đề gì?